Event-Driven Architecture ou Event Sourcing ?
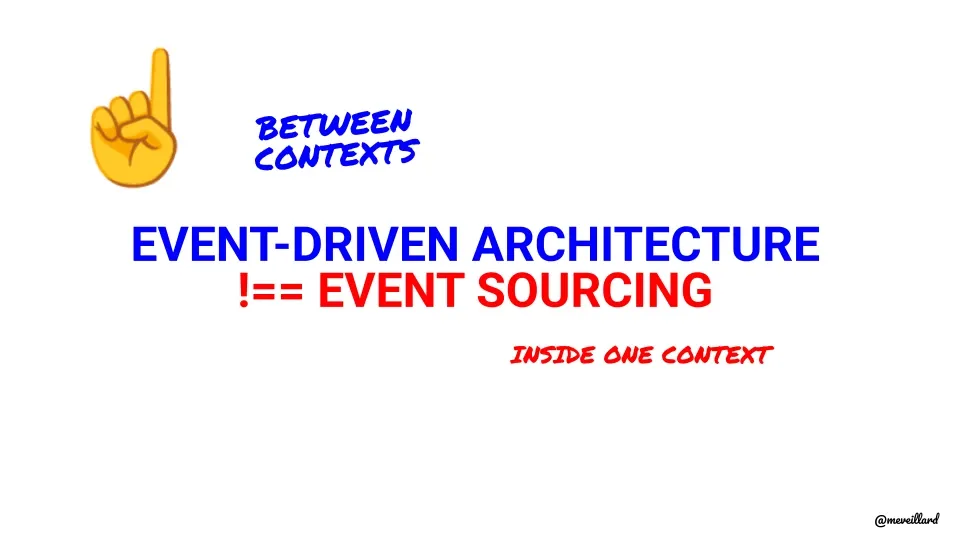
Pareil ? Pas pareil ?
Une question d’échelle
Tout est une question d’échelle, voyez plutôt :
-
Une Event-driven architecture (EDA) est une modalité de communication entre contextes, à comprendre au sens du Domain-Driven Design ;
-
L’Event Sourcing (ES) est un pattern que l’on retrouve à l’intérieur d’un contexte, caractérisé par une écriture append only.
Dans les deux cas, l’information circule sous forme d’événements métiers, caractérisés par un type (par exemple : APPOINTMENT_BOOKED), et généralement accompagnés d’un payload. Ces événements sont précieux, on parle de golden source, parce qu’ils suffisent à reconstituer l’histoire du système.
Voyons cela en détail.
L’Event-driven architecture : un fonctionnement réactif
La beauté de la chose, c’est le découplage :
-
Chaque contexte émet des événements sur un bus de données sans se soucier de qui écoutera (broadcast) ;
-
La responsabilité du bus est de délivrer les événements à tous les contextes ayant souscrit à ce type d’événement (généralement au travers d’un topic), et rien d’autre. Il n’opère aucune transformation, ne procède à aucun traitement. On parle de dumb pipes, par opposition aux ETL (Extract, Transform, Load) ;
-
Les contextes qui écoutent ces événements, quant à eux, ne savent pas quel contexte en est à l’origine.
C’est un fonctionnement réactif : chaque contexte procède à des traitements en réaction à des événements du monde extérieur, émettant d’autres signaux en retour.
Ce fonctionnement est tout à fait singulier : il faut bien comprendre que chaque contexte va accumuler (« sédimenter ») de l’information pour pouvoir travailler ultérieurement, lorsqu’il sera interrogé au travers de son API.
Pourquoi est-ce intéressant ? Parce que l’alternative pour un contexte, c’est d’aller chercher l’information quand il en a besoin. Dès lors, si le contexte qui possède l’information n’est pas disponible, l’appelant ne peut pas travailler. Par contraste, une EDA favorise l’autonomie des contextes.
On pourrait en dire beaucoup plus sur le sujet, mais le but est de voir en quoi une telle architecture diffère de l’Event Sourcing, alors parlons d’Event Sourcing.
L’Event Sourcing : un fonctionnement append only
Bis repetita placent : l’ES est une architecture que l’on retrouve à l’intérieur d’un contexte. Elle répond à un besoin précis : la traçabilité. La comptabilité et le transport maritime constituent des cas d’école (1).
En comptabilité, si l’on a procédé par erreur à un débit de 100 €, on ne peut pas simplement supprimer l’écriture correspondante, car le risque de falsification des comptes serait trop grand. Pour cette raison, la seule possibilité est de créer un événement « contraire », à savoir une extourne de 100 €. Au lieu de supprimer un événement, on en ajoute un. On ne peut qu’ajouter des événements, ce que désigne le terme append only.
Dans cette architecture, on ne stocke pas l’état courant du système, mais la suite des événements métier qui ont conduit à cet état. Les événements suffisent à reconstituer l’état courant, qui n’est qu’une projection. Évidemment, on sent bien que l’idée ne tient plus quand il faut reconstruire l’état à partir de 50 000 événements (par exemple, le solde de votre compte bancaire ouvert en 2004). Cela nous conduit à créer en parallèle de l’Event Sourcing un modèle de lecture (un snapshot de l’état du système), et à réinventer au passage le CQRS (distinction entre modèle d’écriture, pour l’audit, et de lecture, pour la performance).
Là encore, on pourrait aller beaucoup plus loin, en parlant de commandes, de fonctions de décision et d’évolution, puis en détaillant le lien entre ES et CQRS (2 concepts indépendants, qui marchent très bien ensemble). Mais ce serait trop pour un seul article 🙂
(1) Voir à ce sujet l’article de Martin Fowler : https://martinfowler.com/eaaDev/EventSourcing.html.