Don't Repeat Yourself… but un peu quand-même
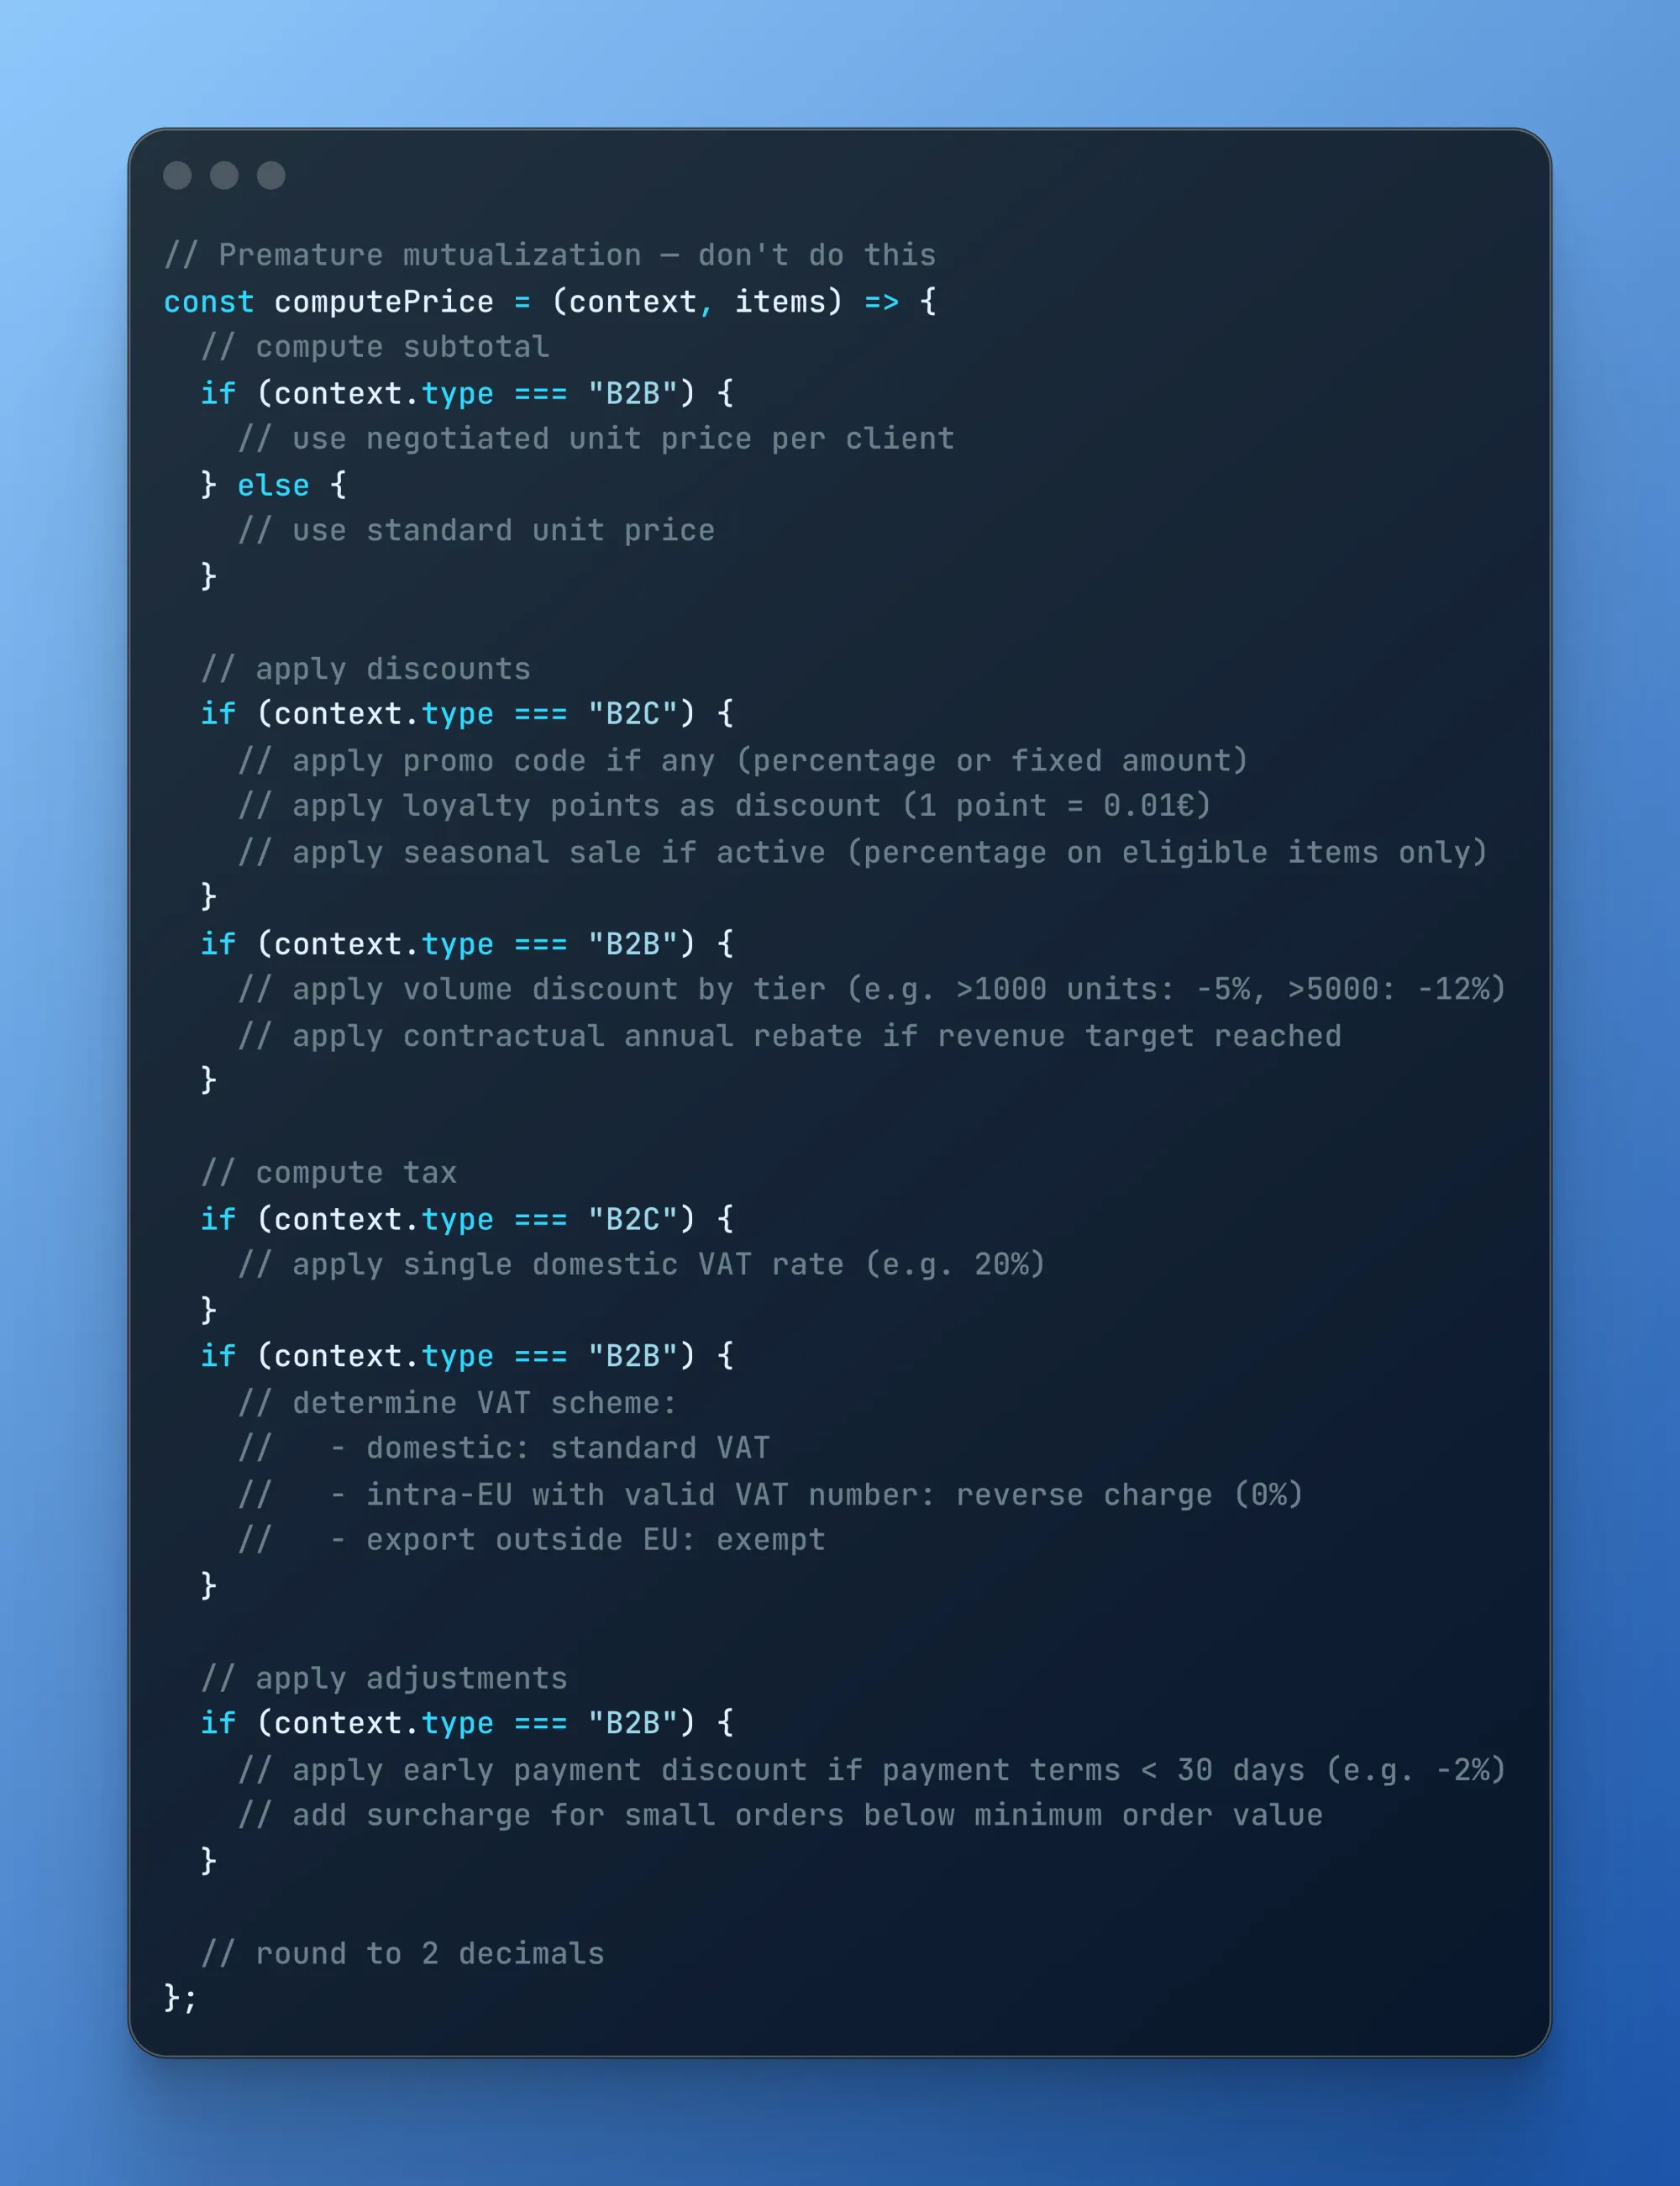
DRY (Don’t Repeat Yourself) est un excellent principe. Seulement, il ne saurait être appliqué à l’aveugle, au risque de devenir contre-productif. Considérons cet exemple de calcul de prix.
Quand la généricité n’a pas de sens métier
Vous conviendrez avec moi que quelque chose coince à la lecture de ce (pseudo-)code. Tous ces if nous interpellent, le flux d’exécution de la fonction est heurté. On sent bien qu’il y a au fond 2 voies parallèles (B2B et B2C), chacune assez simple.
C’est bien le cas. Ici, nous avons mutualisé trop tôt. Nous avons mutualisé des traitements qui n’auraient pas dû l’être d’un point de vue métier. Le code qui en résulte est un Frankenstein de généricité.
Nous avons été tentés de procéder ainsi parce qu’il y a une similarité de forme. Oui, on calcule un total brut, auquel on applique des réductions, puis la TVA. Mais à chaque étape, la manière de procéder est radicalement différente, parce que l’approche est B2B d’une part, B2C de l’autre. Autrement dit, la similarité de forme ne correspond à aucune réalité métier (similarité accidentelle vs. essentielle).
Ce qui doit nous mettre la puce à l’oreille, c’est que la fonction a deux raisons de changer : des raisons liées au B2B, d’autres liées au B2C. À vouloir trop exercer le sacro-saint principe DRY, nous avons violé le SRP (Single Responsibility Principle) et introduit un couplage indu. Quand on mutualise, on crée une dépendance. Chaque évolution d’un cas d’usage risque de casser l’autre.
Que donnerait d’ailleurs ce code si l’on devait à présent travailler en B2B2C ? Ce serait un cauchemar. Le coût d’une mauvaise abstraction est exponentiel : chaque nouveau cas d’usage doit composer avec tous les précédents.
Alors que faire, et quand mutualiser ?
Dupliquer pour mieux abstraire
Pour répondre à cette question, encore faut-il être en mesure d’apprécier la similarité des deux algorithmes. Et donc, aussi paradoxal que cela puisse sembler pour nous qui avons été biberonnés au DRY, le bon réflexe est plutôt de dupliquer les comportements – dans un premier temps du moins.
Dupliquer pour mieux constater :
- Si les implémentations ont 90% de code en commun, mutualiser est intéressant (c’est un critère subjectif, vous l’aurez compris)
- Si au contraire elles ne partagent que peu (disons 50% seulement), mutualiser n’est pas la bonne chose à faire
Mieux vaut dans ce cas-là dupliquer les fonctions de plus haut niveau et reposer sur quelques sous-fonctions communes.
Dans notre exemple, cela pourrait donner le pseudo-code suivant :
const computeB2CPrice = (context, items) => {
  // compute subtotal (unit price × quantity)
  // apply promo code if any (percentage or fixed amount)
  // apply loyalty points as discount (1 point = 0.01€)
  // apply seasonal sale if active (percentage on eligible items only)
  // compute VAT (single domestic rate, e.g. 20%)
  // round to 2 decimals
};

const computeB2BPrice = (context, items) => {
  // compute subtotal (negotiated unit price per client × quantity)
  // apply volume discount by tier (e.g. >1000 units: -5%, >5000: -12%)
  // apply contractual annual rebate if revenue target reached
  // determine VAT scheme:
  //   - domestic: standard VAT
  //   - intra-EU with valid VAT number: reverse charge (0%)
  //   - export outside EU: exempt
  // apply early payment discount if payment terms < 30 days (e.g. -2%)
  // round to 2 decimals
};

// Shared building blocks
const computeSubtotal = (items) => {
  /* ... */
};

const applyTaxRate = (amount, rate) => {
  /* ... */
};

const roundToDecimals = (amount, decimals) => {
  /* ... */
};
Le flux d’exécution de chaque fonction est à présent linéaire, donc facile à lire. Chaque fonction peut être testée au travers de scénarios métiers clairs. Chaque fonction est bien plus facile à maintenir et peut évoluer indépendamment de l’autre.
Là, nous pourrions nous demander s’il n’y a pas, au fond, 2 contextes distincts (au sens du Domain-Driven Design). Je ne le pense pas : même finalité (calculer un prix), donc même contexte (pricing/tarification). Le vocabulaire est commun, de nombreuses données le sont également, il n’y a là que des règles métier qui diffèrent, autrement dit des stratégies/politiques différentes au sein d’un même contexte.
Three strikes and you refactor
Retenons donc qu’un peu de duplication coûte bien moins cher qu’une mauvaise abstraction, que vous allez traîner comme un boulet pendant des mois. Quand on découvre le métier, en particulier, il est urgent d’attendre avant de mutualiser.
On gardera donc en mémoire la recommandation de Martin Fowler :
The first time you do something, you just do it. The second time you do something similar, you wince at the duplication, but you do the duplicate thing anyway. The third time you do something similar, you refactor.
Évidemment, ce conseil ne s’applique pas pour des fonctions purement génériques/techniques (parsing, formatage…), qui n’ont pas besoin de métier pour exister.