Command Query Responsibility Segregation
On en entend beaucoup parler, depuis plusieurs années. Sur le papier, rien de bien compliqué. Dans les faits, c’est autre chose. Le CQRS, acronyme de Command Query Responsibility Segregation, est un outil qu’il faut utiliser à bon escient, et tout est affaire de cas d’usage.
Partons justement d’un exemple afin de bien comprendre le problème que le CQRS résout.
4, 8, 15, 16, 23, 42…
Imaginez une API REST exposant deux routes :
- Un verbe POST vous permettant d’enregistrer un simple nombre : 4, 8, 15, 16, 23, 42…
- Un verbe GET vous permettant d’obtenir la moyenne de tous les nombres ainsi enregistrés : 4.0, 6.0, 9.0, 10.8, 13.2, 18.0…
Le fonctionnel n’est pas foufou, me direz-vous, mais il a le mérite d’être simple.
Ajoutons à présent une contrainte : pouvoir expliquer la valeur de la moyenne ainsi calculée si une procédure d’audit venait à être déclenchée. La seule façon d’expliquer la valeur 18.0 est de montrer à l’auditeur une suite de nombres (4, 8, 15, 16, 23, 42) dont la moyenne vaut 18.0.
Je vous passe l’implémentation des contrôleurs afin d’étudier le modèle de données sous-jacent. Commençons par une implémentation naïve : type Model = number; en TypeScript. Ce modèle est naturellement adapté au POST, en revanche le GET risque de poser problème quand la volumétrie augmentera.
Imaginez en effet calculer la moyenne de 100 000 nombres. Quelle que soit la couche qui s’en charge (couche applicative ou bien couche de persistance), à la fin quelqu’un devra bien faire la somme de 100 000 valeurs et les compter pour diviser par 100 000. On doit pouvoir faire mieux.
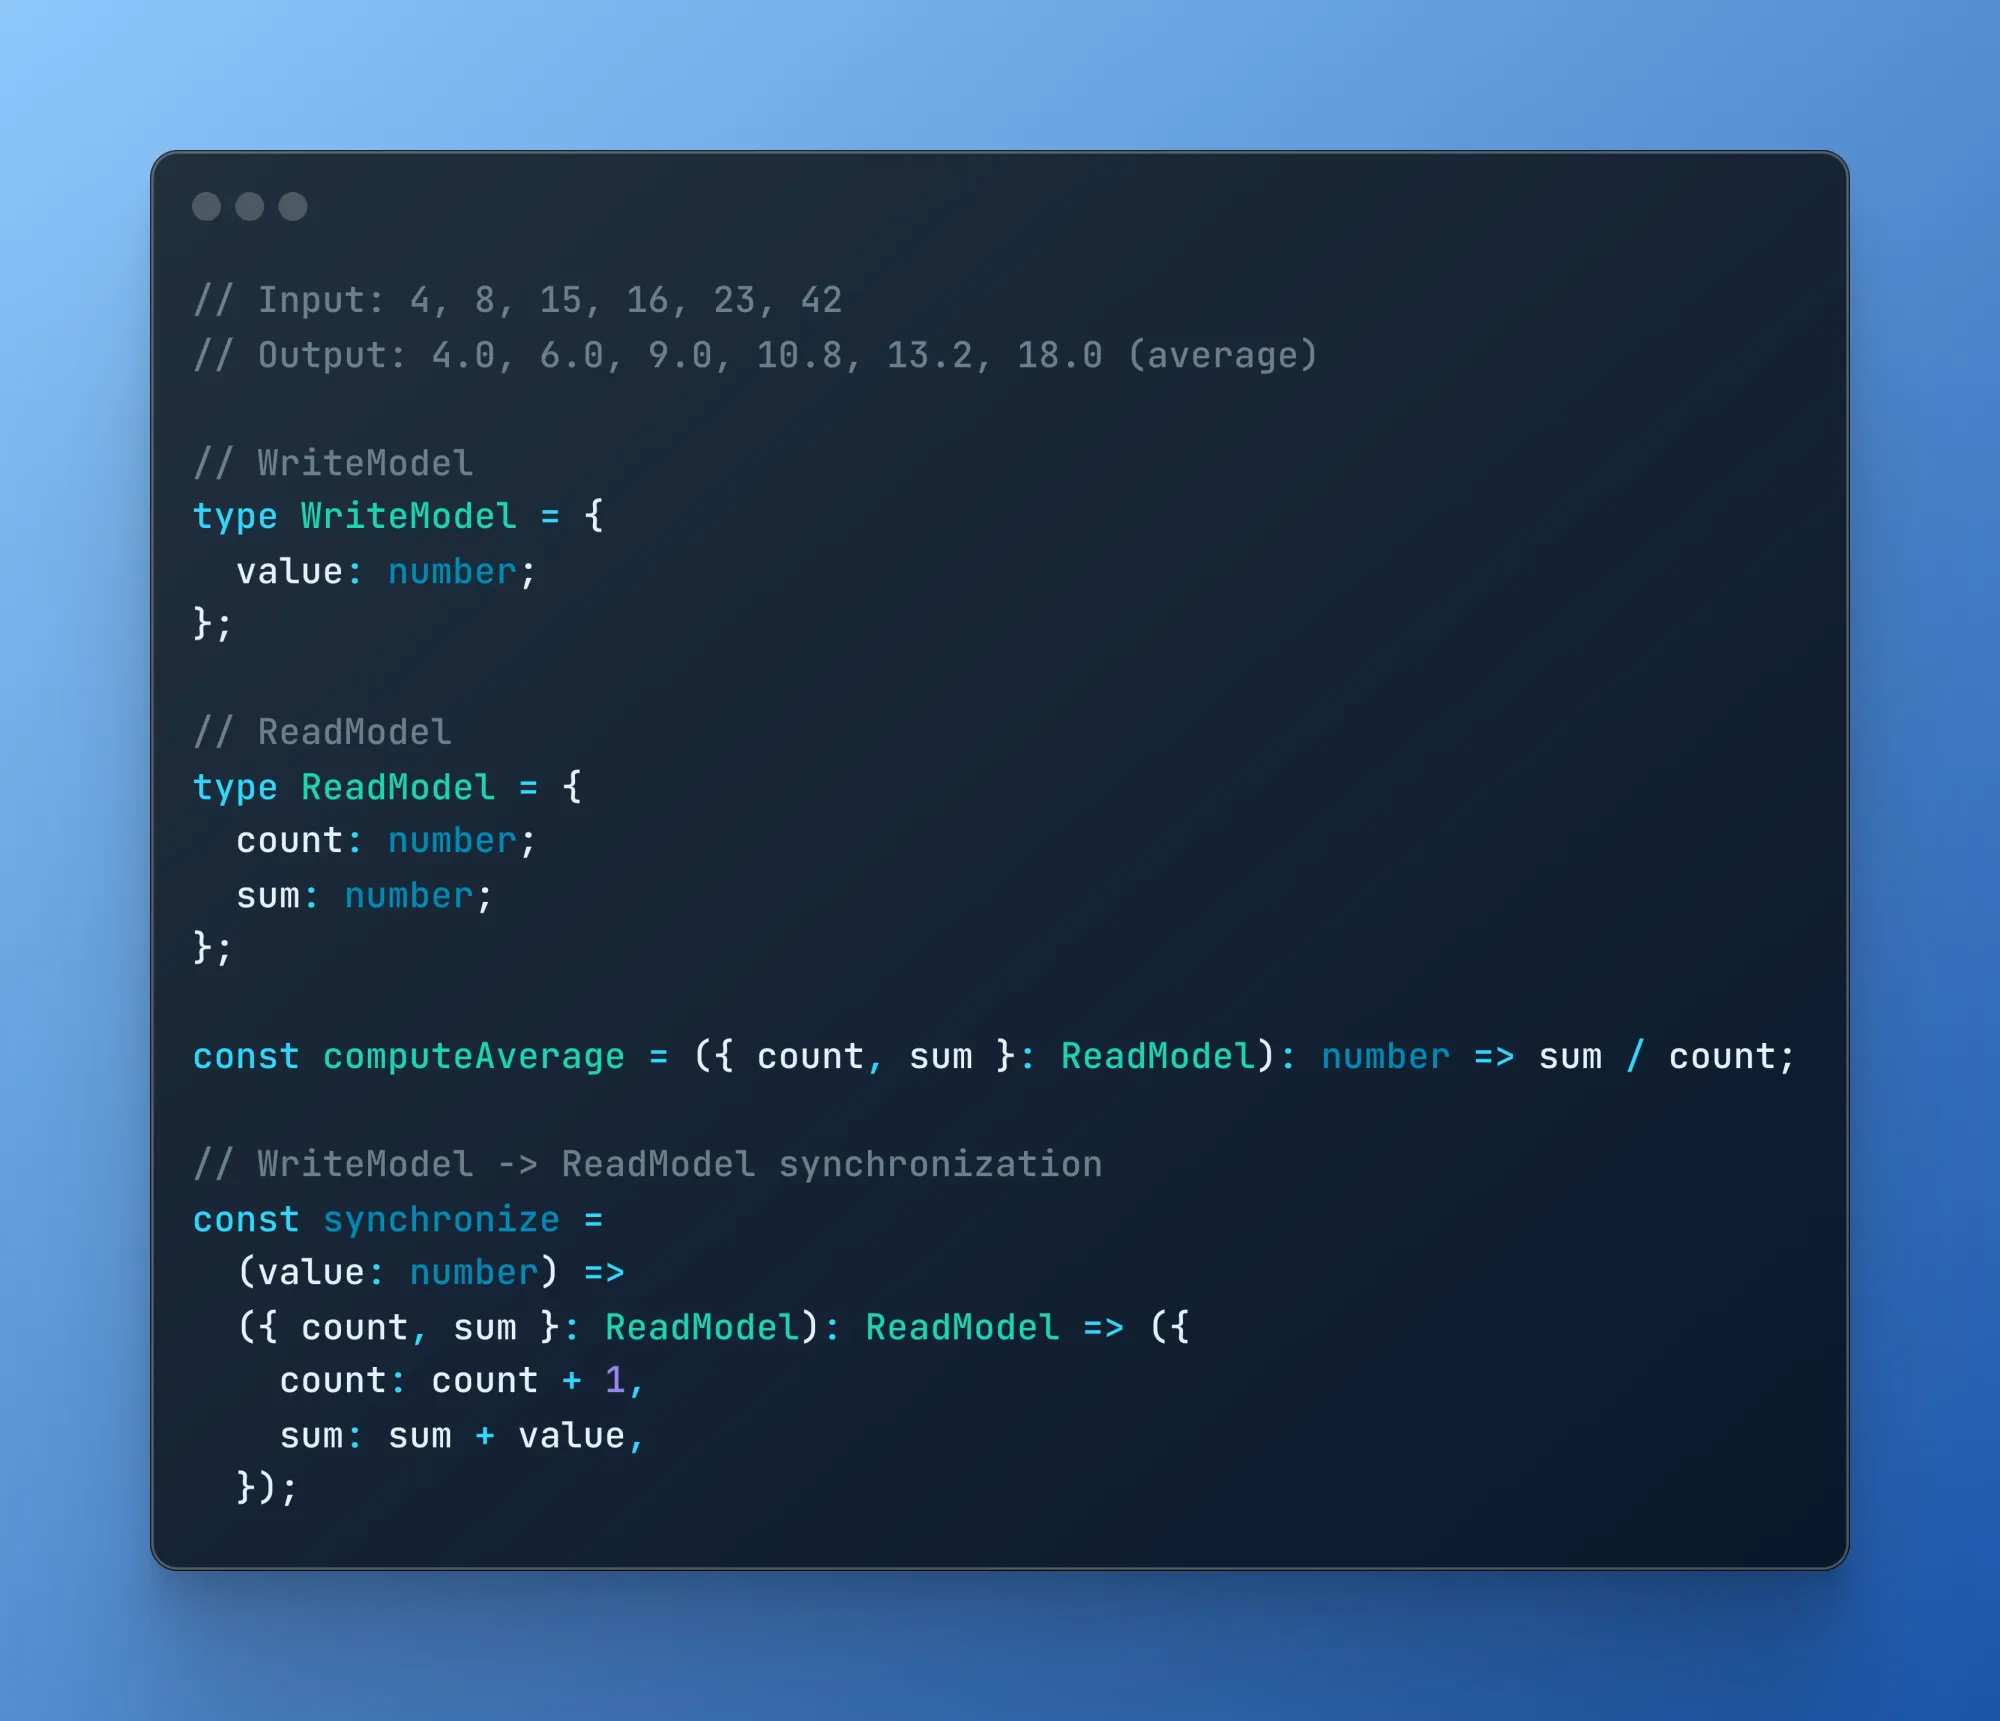
L’idée est alors de créer deux modèles distincts : un modèle d’écriture et un modèle de lecture. Ce qui pourrait donner, toujours en TypeScript :
// WriteModel
type WriteModel = {
  value: number;
};

// ReadModel
type ReadModel = {
  count: number;
  sum: number;
};

const computeAverage = ({ count, sum }: ReadModel): number => sum / count;

// WriteModel -> ReadModel synchronization
const synchronize =
  (value: number) =>
  ({ count, sum }: ReadModel): ReadModel => ({
    count: count + 1,
    sum: sum + value,
  });
Le WriteModel est très proche du modèle naïf. En base de données, vous retrouverez la suite des valeurs 4, 8, 15, 16, 23, 42. Le ReadModel, en revanche, est vraiment nouveau, puisqu’il va donner lieu à deux enregistrements en base de données : 108 (la somme des valeurs) et 6 (le nombre de valeurs). Il ne restera plus qu’à faire la division, au dernier moment (1).
Ce faisant, nous avons réinventé le CQRS.
Définition du CQRS
Le CQRS peut être envisagé dans le cas où les opérations d’écriture et de lecture sont asymétriques. Soit parce que les opérations sont de natures très différentes, soit parce qu’elles sont associées à des charges de travail, donc des besoins en termes de scalabilité très différents (beaucoup plus d’appels d’un côté que de l’autre).
En pareille situation, plutôt qu’un modèle généraliste faisant un peu tout mais vraiment rien, le CQRS fait le choix de distinguer deux modèles, qui vont pouvoir diverger et se spécialiser :
- Un modèle pour l’écriture = Command : on commande au système de faire quelque chose (2) ;
- Un modèle pour la lecture = Query : on effectue une requête pour connaître l’état du système.
Avec une nécessaire synchronisation des deux modèles.
À noter en passant : qui dit modèles distincts dit changement de contexte (réflexe du Domain-Driven Design) :
- Un contexte d’écriture : dit comme ça, c’est peut-être un peu bizarre (écrire pour ne jamais lire ?), mais en fait il y a bien une finalité de lecture, c’est la traçabilité / la preuve. Sans elle, la commande alimenterait directement le modèle de lecture et il n’y aurait qu’un modèle.
- Un contexte de lecture : notre besoin initial.
Le CQRS n’est donc, au fond, qu’une heuristique parmi d’autres de découpage en bounded contexts.
Les modèles étant distincts, il en est de même de la persistance. Cela veut dire, selon vos modalités de déploiement, des bases de données distinctes (microservices) ou, des schémas distincts au sein d’une même base de données (monolithe modulaire).
Penchons-nous à présent sur une confusion fréquente, qui rend difficile la compréhension du CQRS.
CQRS !== Event Sourcing
CQRS et Event Sourcing (ES) sont souvent présentés ensemble, au point qu’il peut être difficile de les différencier. Pourtant, chaque architecture a son existence propre :
-
Le CQRS est le fait de distinguer les modèles d’écriture et de lecture pour de meilleures performances. Nous l’avons vu, le CQRS est un pattern architectural qui, par définition, implique deux contextes.
-
L’Event Sourcing, quant à lui, est un mode de fonctionnement append only implémenté au sein d’un seul contexte. Toute modification de l’état du système se traduit par un événement, et la succession de ces événements constitue la source de vérité : un fait est un fait, on ne peut pas revenir dessus. Exemple : votre compte bancaire.
CQRS et ES sont souvent associés, à raison, parce que les deux fonctionnent bien ensemble. L’ES constitue alors le modèle d’écriture.
Mais l’un n’entraîne pas nécessairement l’autre :
-
On peut envisager du ES sans CQRS. C’est rare, parce que l’ES entraîne rapidement des problèmes de performance (vous vous doutez bien que le solde de votre compte bancaire n’est pas calculé à la volée depuis son ouverture en 1999 🤣) ;
-
Réciproquement, on pourrait mettre en place du CQRS sans ES, mais franchement là aussi c’est assez théorique, j’ai presque du mal à trouver un exemple.
Conclusion
Quoi qu’il en soit, gardez à l’esprit que la mise en place d’un pattern CQRS occasionne une vraie complexité, notamment du fait de la synchronisation des modèles. En voulant résoudre un problème de performance, vous en ouvrez d’autres. Il faut donc que le problème initial soit vraiment pregnant et justifie cette complexité additionnelle.
(1) Le mécanisme de synchronisation proposé ici reste naïf. Une implémentation réelle passerait probablement par la publication d’un événement et la mise en place d’une queue de traitement.
(2) On aime à raisonner en termes de commandes pour mieux « capturer » l’intention métier, qui donne lieu in fine à une écriture. Cependant, le principe du CQRS serait inchangé si cette écriture résultait d’un appel à l’API sans formalisme particulier.