Bug, erreur ou cas nominal : quelle intention métier ?
Nous avons vu par le passé qu’il convenait de distinguer 2 types d’erreurs :
- Les erreurs de développement, c’est-à-dire des bugs, pour lesquelles il est justifié de lancer des exceptions (on ne sait pas les gérer, par définition) ;
- Les erreurs de saisie utilisateur ou d’infrastructure, qui sont prévisibles et arriveront tôt ou tard. Ces erreurs sont mieux prises en charge au travers de la monade
Result(type Result<U, E> = Success<U> | Error<E>) et du Railway Oriented Programming.
À ce stade, un écueil serait de ne plus jamais lancer d’exception et de « tout mettre en Result ». Mauvaise idée, bien sûr. Nous allons donc apporter de la nuance.
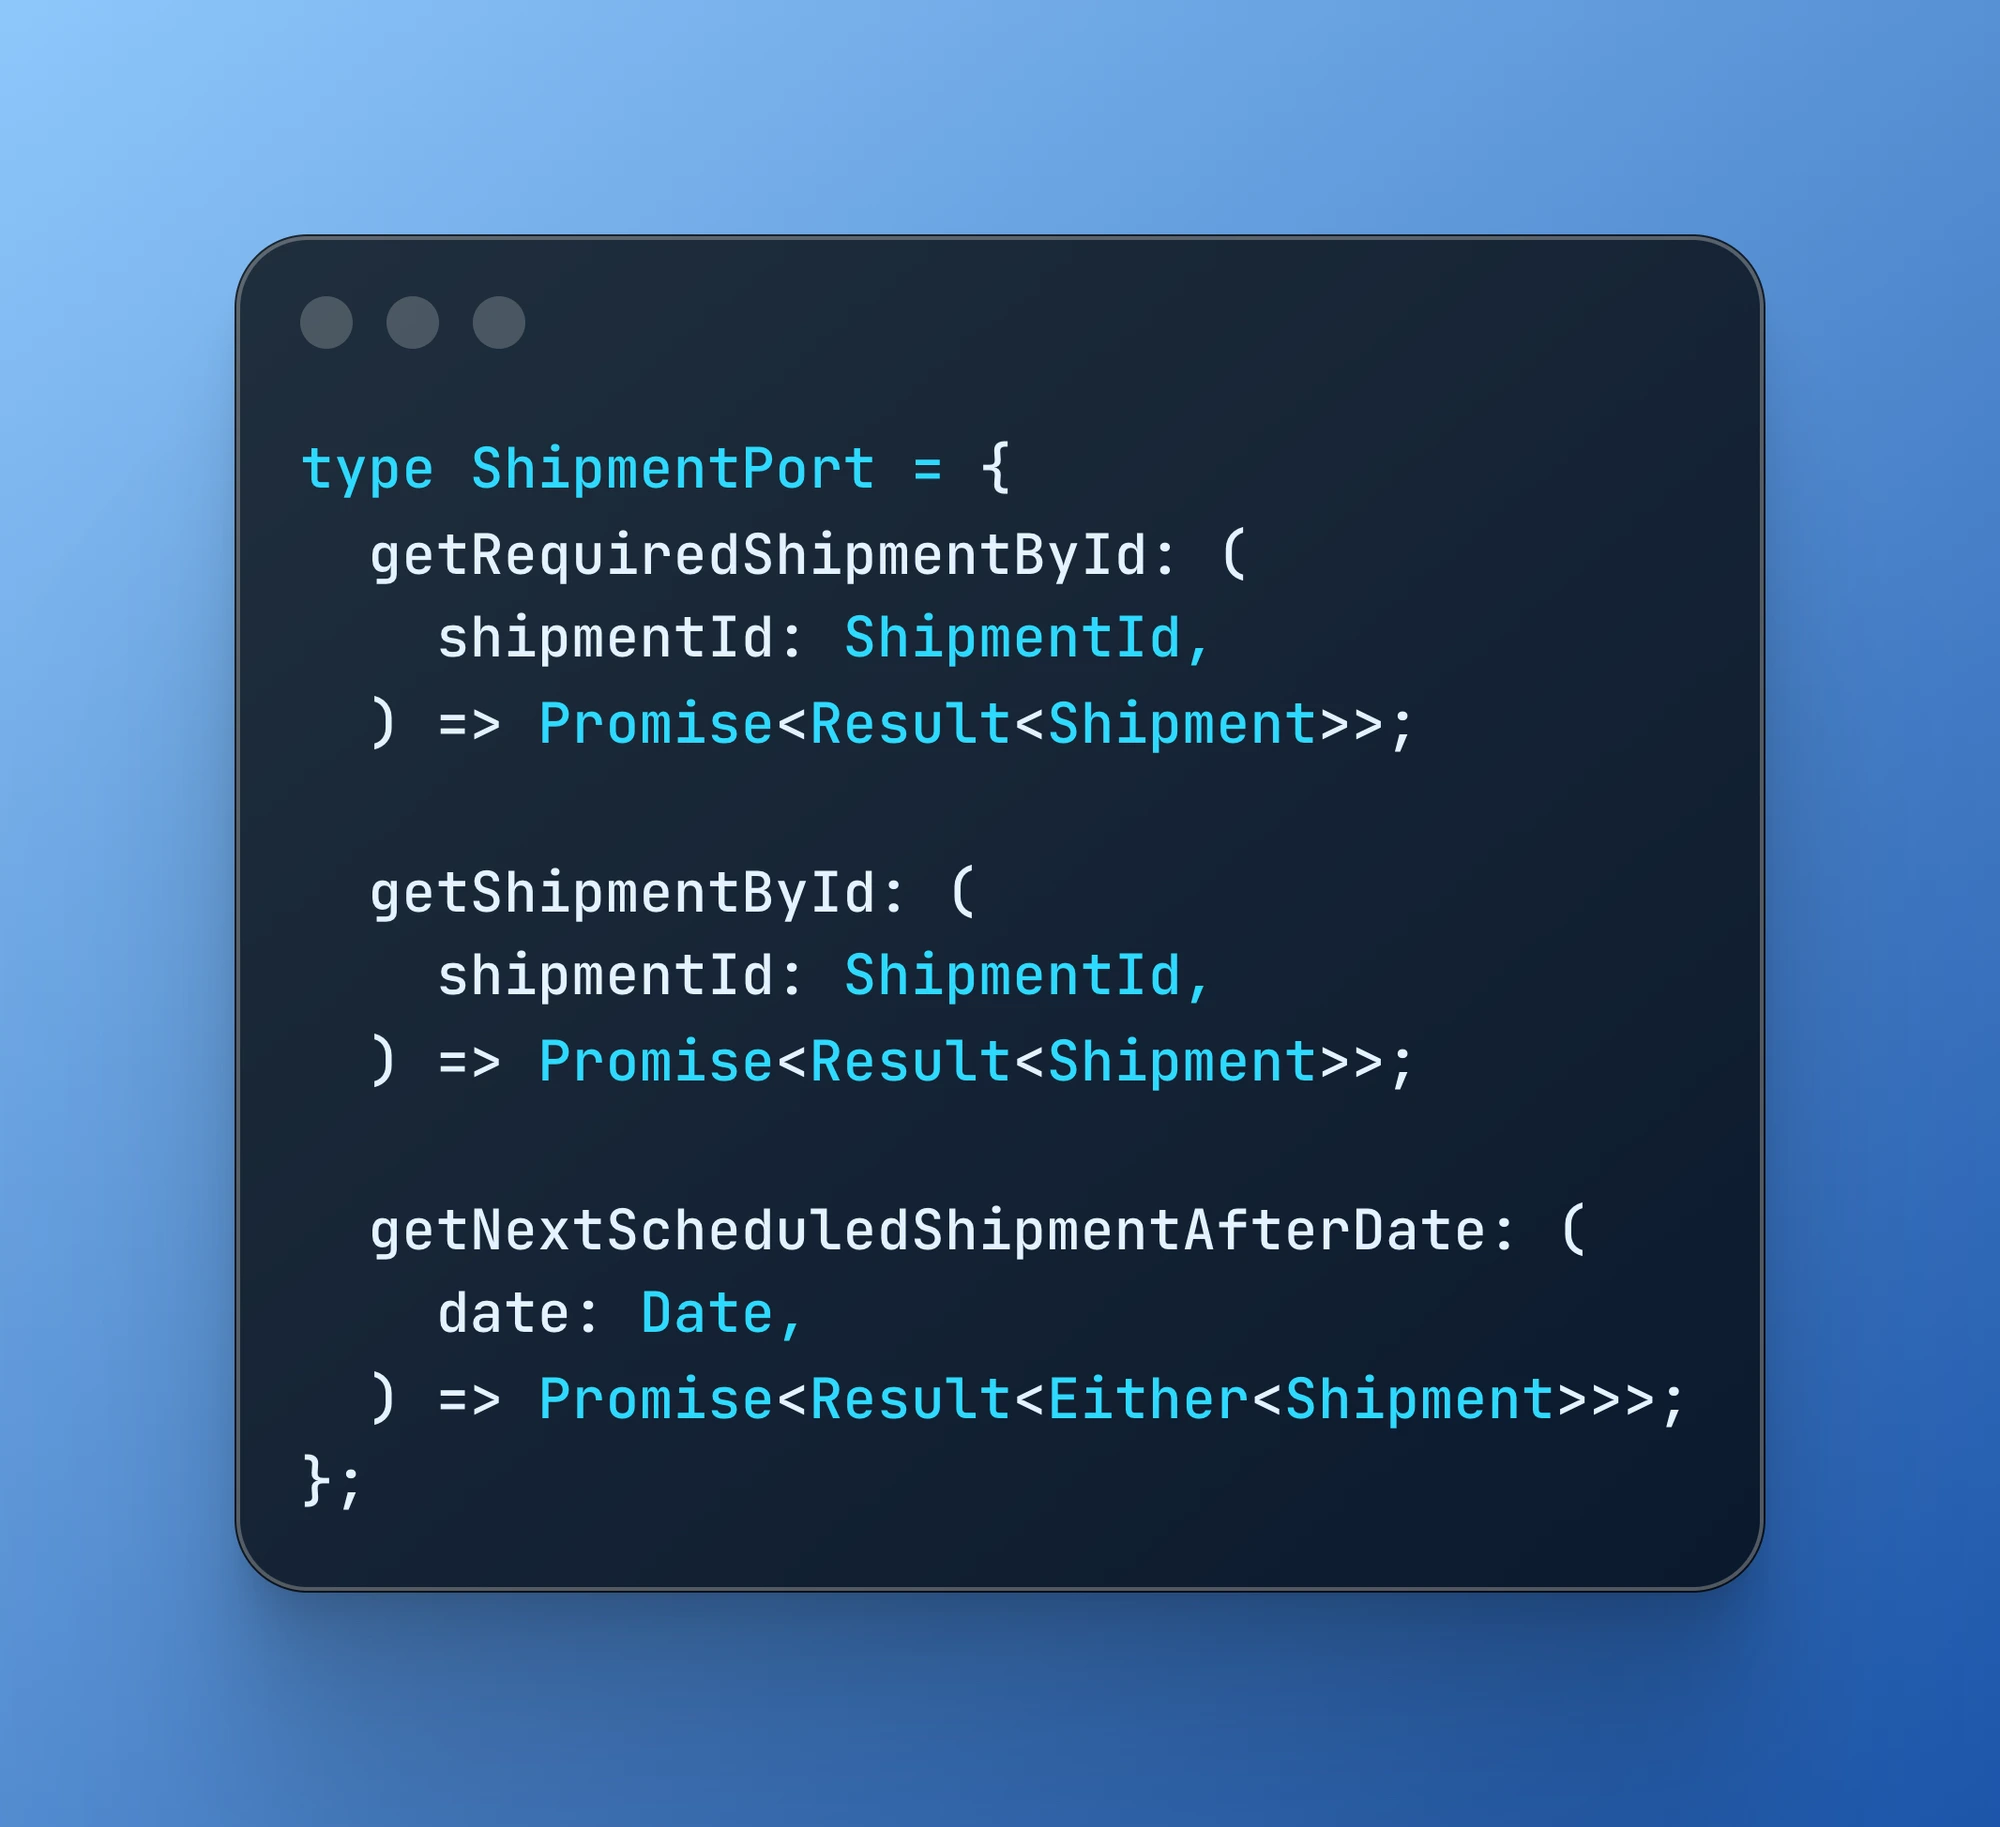
Pour mieux appréhender le sujet, considérons un contexte de logistique et un ShipmentPort exprimant les besoins du domaine en matière de persistance, dans le cadre d’une architecture port/adapters (a.k.a. architecture hexagonale).
Observons à présent ces 3 signatures : getRequiredShipmentById, getShipmentById et getNextScheduledShipmentAfterDate. Nous allons voir qu’elles supposent un sens bien distinct d’un point de vue du métier.
-
getRequiredShipmentById: ici, il est attendu que leShipmentsoit présent en base de données. S’il ne l’est pas, c’est que nous, développeurs, n’avons pas respecté un invariant métier — c’est un bug. C’est, par définition, un cas que l’on ne sait pas gérer, de sorte qu’il convient de lancer une exception (throw). En TypeScript, la signature d’une fonction ne fait pas état des exceptions que cette fonction est susceptible de lancer. On signale donc ce comportement au travers du nommage :Required, ou parfoisOrThrow. À noter que nous utilisons quand-même le typeResult, parce qu’il peut y avoir d’autres erreurs, bien prévisibles quant à elles (base de données qui ne répond pas…) -
getShipmentById: nous sommes ici dans le cas où leshipmentIdest issu de la saisie d’un utilisateur. Le cas où aucunShipmentne correspond à l’ID fourni par l’utilisateur est donc totalement prévisible et doit être envisagé. C’est un cas d’erreur fonctionnelle, puisque l’application ne peut pas travailler sansShipment, mais un cas d’erreur que l’on sait gérer, au travers du sous-typeErrorde la monadeResult. -
getNextScheduledShipmentAfterDate: ici, parler d’erreur est en fait un abus de langage, car l’absence fait partie du scénario nominal, par exemple créer leShipments’il n’existe pas déjà. Notons ici l’usage de la monadeEither(type Either<U> = Some<U> | None), qui est une manière de représenter l’absence deShipment(plus propre que desShipment | null, qui nous contraignent à effectuer de multiples vérifications). Ça fait beaucoup de monades, me direz-vous, mais une fois qu’on y a goûté, difficile de revenir en arrière 🙂
On pourrait croire que le troisième cas introduit un nouveau type d’erreur. Mais nous l’avons vu, ce cas est en fait un cas nominal, de sorte qu’il n’y a que 2 cas d’erreur, ceux évoqués en introduction : bug ou erreur prévisible.
Que retenir de tout cela ? Que c’est le métier qui détermine dans quel cas nous nous trouvons :
- Est-ce qu’un
Shipmentdoit exister à ce stade du processus logistique ? - Est-ce que son absence est une possibilité réaliste ?
- Est-ce que cette absence déclenche une action métier ?
NB : Précisons également que ShipmentId est l’encapsulation d’un ID avec émulation de typage nominal, une façon de faire qui évite bien des erreurs liées à la primitive obsession.